Building

an

idea

Thinking

it

through

Making

room

again

Building

an

idea

Thinking

it

through

Making

room

again

Building

an

idea

Thinking

it

through

Making

room

again

2026年9月22日

招聘团队最熟悉的画面,是周一早上打开三个地方:对外的招聘页面、员工随手转发的内推链接,以及自己邮箱里的简历。三处都有候选人,却没有一张单子能回答这个人现在走到哪了。等走到发 Offer,审批在聊天里,合同在另一封邮件里,入职材料又回到网盘。

智能招聘系统把这三处收成一条申请。管理端给招聘团队用,招聘官网给候选人用,AI 在读简历、写职位描述、出面试题、写评估和做预测时给出可复核的结果。改变状态、发出 Offer、签署合同,仍然由有权限的人确认。

它不代替审批人发 Offer,也不代替候选人签字。招聘如果已经同时发生在官网、内推和邮箱里,它负责让一份申请在系统里有连续的记录。

三条入口,一个候选人池

系统分成三块,后端按领域拆成网关、系统、招聘、面试、Offer、人才库、内推和 AI 引擎:

  • 招聘管理端:HR、面试官、审批人和管理员使用。技术上是 Vue 3、Element Plus 和 Pinia。

  • 招聘官网:社会招聘、校园招聘、热门职位和官网内容。未登录可以浏览已发布职位并投递。

  • 员工内推:计划、职位和奖金在内部维护。访客通过分享链接或海报打开落地页,上传简历即可提交。

无论人从哪里来,申请都会记下来源:主动投递、员工内推、招聘门户、猎头、校园招聘、社会招聘、官网投递。渠道统计还能看到智联招聘、前程无忧、猎聘、BOSS 直聘、LinkedIn 和内部推荐。后面的漏斗和渠道分析用的是同一套口径。

候选人账号和内部账号是分开的。求职者登录之后去看「我的投递」、确认 Offer、签署合同、维护个人资料,打不开职位管理和审批。内部菜单再按权限细分,招聘负责人、审批人和面试官看到的侧栏并不相同。

简历先被读完,再由人做决定

简历上传之后,系统解析正文。图片简历走单独的解析。列表里能看到进度,详情里能预览原文,也能看到 AI 的筛选结果。HR 可以改筛选状态、把简历挂到正确的职位上,也可以一次提交一批并查看这批走到哪了。

写职位时,除了手写职责,还可以提交一次 JD 生成任务,完成后再取回文案,决定用不用。职位只有草稿、已发布、已关闭、已取消四种状态。官网公开列表只接已发布的职位。

候选人中心负责把人往下送。申请会经过新建、筛选、简历通过、面试、Offer、接受、入职,也可能淘汰、撤回、进入储备或黑名单。每一次阶段变化都留下历史,多个人可以一起流转。工作台把 KPI、漏斗、部门进度、最近动态和待办放在一起,待办可以完成,也可以忽略。

面试从空白页变成一套可复用的题

面试可以是电话、视频或现场,也可以是技术面、HR 面、领导面或 AI 面试。日程和周视图用来排期。状态覆盖已安排、进行中、已完成、取消、改期和爽约。面试官提交反馈,结论是通过、淘汰或复试。通知里的面试链接会落到这场面试的报告。

出题

一条路是按职位和候选人生成题目,题目多的时候走异步任务,页面不必干等。另一条是题库:单选、多选、判断、简答、论述、编程、口答、情景都在,难度和考察方向(技术、行为、逻辑、文化匹配)可以分开标。在线测评把题目发给候选人,对方从公开链接作答并提交。

评估

模型可以先写一稿评估,整段返回或边生成边显示。建议落在强烈推荐、推荐录用、考虑录用、不建议录用、重新评估这几档,和面试官的反馈并排,不代替面试官点下通过或淘汰。

从 Offer 到工位,仍是一张单子

Offer 从草稿开始,提交后进入待审批。审批流按部门配置,可以启用或停用。通过之后发给候选人,必要时发邮件。候选人拿到的是确认链接,不用登录管理端;HR 也可以在线下沟通之后手工确认。

详情里会给出这份 Offer 被接受的预测,供参考,不会因为预测分数就自动发出或撤回。合同接在后面:审批、发送、HR 签字、候选人凭链接签字、生效或作废。入职单再把材料、设备、导师、培训、账号和欢迎通知拆成可勾选的步骤,并给出留存预测。状态走到已完成、暂停或终止,这个人才算送出招聘流程。

内推和人才库

内推计划里可以挂职位、设奖金、随时停用。员工生成分享令牌或海报,访客打开的是对应职位。提交记录回到内推记录、我的内推和排行榜,奖金可以标记发放,人岗匹配也可以按这条记录重新算一次。

没有走完的候选人进入人才库。可以搜索、打标签、记一次联系,把库同步到搜索索引,再按目标职位做推荐。推荐同样可以异步取回。下一次开岗时,招聘团队检索的是自己已经读过的人。

数据分析把漏斗、渠道、候选人趋势、招聘周期、面试、Offer 和入职放在同一页,需要汇报时可以导出。监控页能看到 Agent 的暂停、恢复、日志、任务队列,以及模型 Token 用量。

它不会做的事

它不会代替审批人发出 Offer,不会代替候选人签署合同,也不会把演示构建里的本地数据写回正式库。管理端和官网可以单独打一套只在浏览器里跑的演示,用来讲解流程。

适合谁用

  • 招聘同时发生在官网、内推和邮箱,需要一份申请从头走到入职的团队。

  • 希望简历解析、出题和评估先出草稿,再由面试官和 HR 确认的团队。

  • 需要把社会招聘、校园招聘和员工内推放进同一个候选人池的团队。

管理端、招聘官网和后端可以分开部署。申请从发布职位开始,到入职或人才库结束,中间每一步都留在同一条记录上。

2026年9月22日

保存网页图片这件事,听起来简单,做起来却很烦。右键一张张另存为太慢;整页截图又糊、又裁不干净;浏览器扩展则常常把缩略图、图标和真正的内容图混在一起。

Image Downloader 是一个很小的 Python 工具:打开网页,抽出图片地址,优先拿页面已经给出的最高清版本,再存到本地。它不为了“尽可能大”去伪造签名链接,也不默认改你的图片参数。

它不追求全能爬虫,也不假装能突破登录墙。如果你经常需要把某几页上的配图备份下来,它刚好够用。

项目地址→ Github

它到底做什么

给它一个或多个网页地址,它会依次完成这些步骤:

  1. 从你粘贴的文本里识别 HTTP / HTTPS 网址,自动清理末尾标点并去重。

  2. 请求页面 HTML。Pixiv 作品页会走插画接口拿全部原图;其他站点用 BeautifulSoup 找 <img>。

  3. 在普通页面上,优先使用 data-full、data-hires、srcset,或指向图片文件的父级链接;没有更好地址时才回退到 src / data-src。

  4. 跳过 data: 内嵌图。同一张图出现多种尺寸时,只保留质量最高的那一个。

  5. 默认按原始图片链接下载。只有你主动选择改参数时,才会替换或追加查询字符串。

  6. 文件保存到 downloaded_images 目录,遇到重名会自动加前缀,避免覆盖。单张失败会跳过,同一页其余图片继续下。

关键设计是:网页地址永远不会被改写;图片地址默认也不改。 下载时会带上源页面作为 Referer,这对 Pixiv 这类图床尤其重要。

针对几个站点的额外处理

Pixiv

遇到 /artworks/{id} 作品页时,工具会请求插画元数据,拼出全部 img-original 原图地址,而不是页面上的缩略图。多页作品会按页下载。

note.com

对于 assets.st-note.com/img/ 的图片,会改写成点击放大时使用的 CDN 参数:约 4000 像素、质量 90。同一资源路径只保留一个版本。

Patreon

Patreon 的媒体地址是签名过的。工具会优先使用页面真实提供的点击原图链接(来自包围图片的 <a> 或页面内嵌数据),并原样保留访问令牌。它不会伪造新的签名 URL,也不会改写 Patreon 的查询参数。只有 hash、没有过期时间的链接会被跳过。

可选:改图片链接参数

开始下载前,程序会问要不要修改图片 URL 的查询参数。直接回车或选 n,就按原始链接下载。选 y 后,可以输入一组参数,例如:

caw=1920&format=webp

已有同名参数会被替换,新参数会被追加。页面网址不会被动;已签名的 Patreon 媒体地址也不会被改。

https://example.com/a.jpg?caw=500
→ https://example.com/a.jpg?caw=1920&format=webp

两种运行方式

交互式:适合临时粘贴一批链接

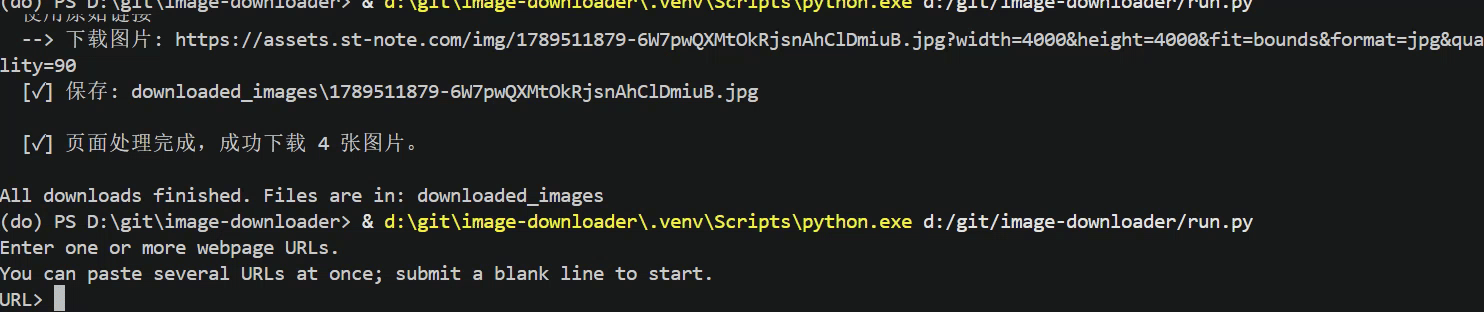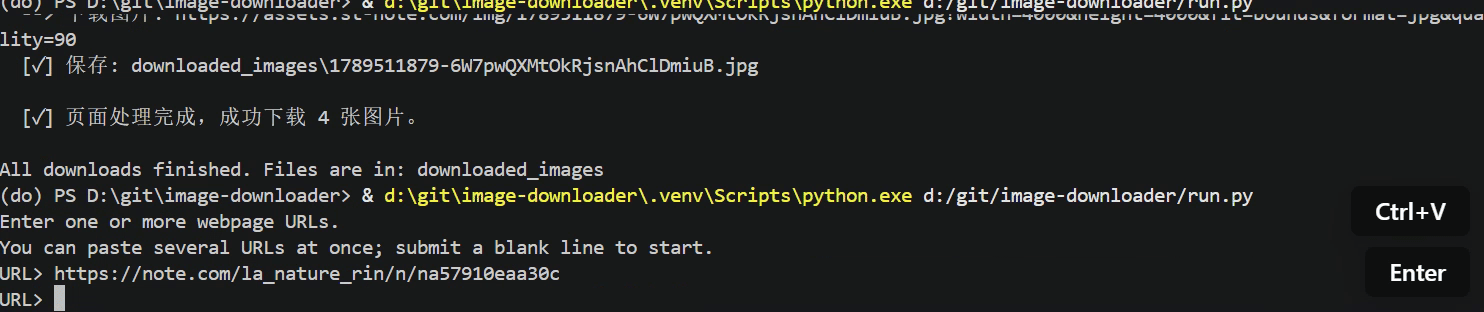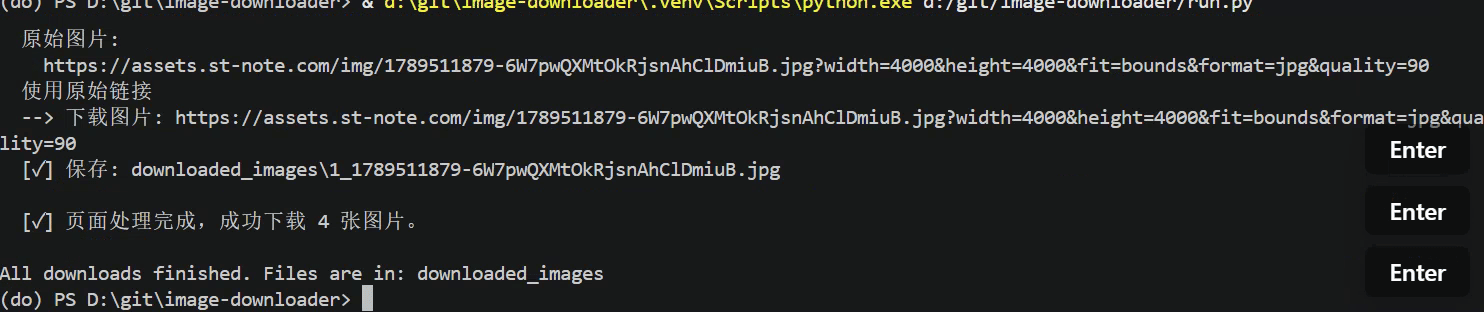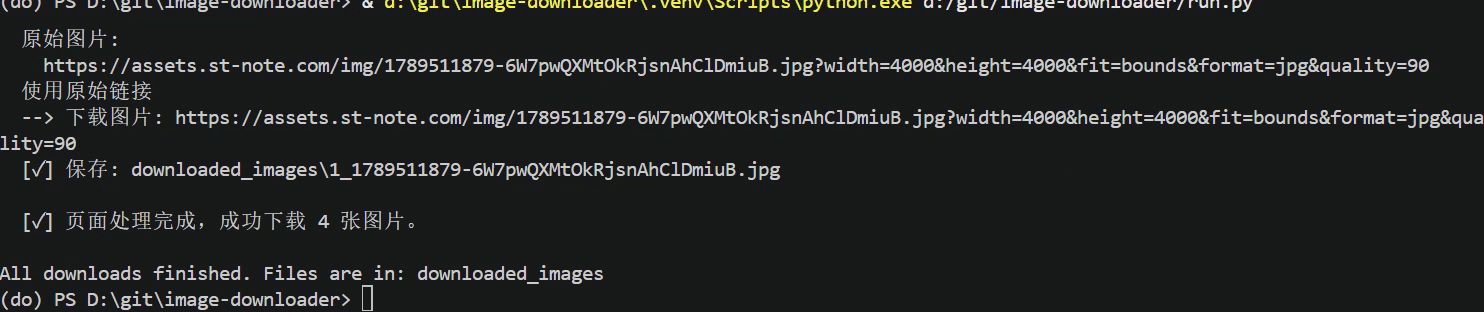
启动控制台后,每行输入一个网址,也可以一次粘贴含多个网址的文本。空行确认后继续:

python run.py


Enter one or more webpage URLs.
URL> https://example.com/page-one
URL> https://example.com/page-two
URL

无效文本会被忽略,重复网址只处理一次。全部完成后,文件在 downloaded_images 目录里。

源文件模式:适合固定清单反复跑

把网址写进 do.py 顶部的 RAW_TEXT,然后运行:

python do.py

两种入口共用同一套提取、选图、询问改参和下载逻辑,差别只在网址从哪来。

安装

需要 Python 3.13 或更高版本,以及能访问目标网页和图片服务器的网络。依赖很少:requests 负责请求,beautifulsoup4 负责解析 HTML。

python -m venv .venv
.\.venv\Scripts\Activate.ps1
python -m pip install --upgrade pip
python -m pip install -e

如果 PowerShell 禁止激活虚拟环境脚本,先在当前会话执行:

Set-ExecutionPolicy -Scope Process -ExecutionPolicy RemoteSigned
.\.venv\Scripts\Activate.ps1

可以改的配置

都在 do.py 文件顶部:

  • SAVE_DIR:本地保存目录,默认 downloaded_images。

  • HEADERS:请求头。默认带常见浏览器 User-Agent;个别站点如果校验来源,可以打开注释里的 Referer。

它不会做的事

部分网站会拦截自动化请求,或要求登录后才能看到图片。这个工具不会绕过这些限制。仅登录可见的 Pixiv 或 Patreon 内容,在页面本身无法公开访问时会失败。

它主要认页面里的 <img> 和少数站点接口,不会去解 CSS 背景图,也不会猜测需要额外登录态才能拿到的资源。

把它当成一个诚实的小助手:给你能访问的页面,它帮你把最高清的那张捞下来;遇到墙,它会告诉你失败,而不是假装成功。

适合谁用

  • 需要把参考页、作品页或图文稿里的配图批量存档的人。

  • 经常从 Pixiv、note.com 或 Patreon 公开页备份原图,又不想为一次性任务写完整爬虫的人。

  • 已经有一串乱七八糟的文本,只想从中抽出网址再下载的人。

2026年9月22日

保存网页图片这件事,听起来简单,做起来却很烦。右键一张张另存为太慢;整页截图又糊、又裁不干净;浏览器扩展则常常把缩略图、图标和真正的内容图混在一起。

Image Downloader 是一个很小的 Python 工具:打开网页,抽出图片地址,优先拿页面已经给出的最高清版本,再存到本地。它不为了“尽可能大”去伪造签名链接,也不默认改你的图片参数。

它不追求全能爬虫,也不假装能突破登录墙。如果你经常需要把某几页上的配图备份下来,它刚好够用。

项目地址→ Github

它到底做什么

给它一个或多个网页地址,它会依次完成这些步骤:

  1. 从你粘贴的文本里识别 HTTP / HTTPS 网址,自动清理末尾标点并去重。

  2. 请求页面 HTML。Pixiv 作品页会走插画接口拿全部原图;其他站点用 BeautifulSoup 找 <img>。

  3. 在普通页面上,优先使用 data-full、data-hires、srcset,或指向图片文件的父级链接;没有更好地址时才回退到 src / data-src。

  4. 跳过 data: 内嵌图。同一张图出现多种尺寸时,只保留质量最高的那一个。

  5. 默认按原始图片链接下载。只有你主动选择改参数时,才会替换或追加查询字符串。

  6. 文件保存到 downloaded_images 目录,遇到重名会自动加前缀,避免覆盖。单张失败会跳过,同一页其余图片继续下。

关键设计是:网页地址永远不会被改写;图片地址默认也不改。 下载时会带上源页面作为 Referer,这对 Pixiv 这类图床尤其重要。

针对几个站点的额外处理

Pixiv

遇到 /artworks/{id} 作品页时,工具会请求插画元数据,拼出全部 img-original 原图地址,而不是页面上的缩略图。多页作品会按页下载。

note.com

对于 assets.st-note.com/img/ 的图片,会改写成点击放大时使用的 CDN 参数:约 4000 像素、质量 90。同一资源路径只保留一个版本。

Patreon

Patreon 的媒体地址是签名过的。工具会优先使用页面真实提供的点击原图链接(来自包围图片的 <a> 或页面内嵌数据),并原样保留访问令牌。它不会伪造新的签名 URL,也不会改写 Patreon 的查询参数。只有 hash、没有过期时间的链接会被跳过。

可选:改图片链接参数

开始下载前,程序会问要不要修改图片 URL 的查询参数。直接回车或选 n,就按原始链接下载。选 y 后,可以输入一组参数,例如:

caw=1920&format=webp

已有同名参数会被替换,新参数会被追加。页面网址不会被动;已签名的 Patreon 媒体地址也不会被改。

https://example.com/a.jpg?caw=500
→ https://example.com/a.jpg?caw=1920&format=webp

两种运行方式

交互式:适合临时粘贴一批链接

启动控制台后,每行输入一个网址,也可以一次粘贴含多个网址的文本。空行确认后继续:

python run.py


Enter one or more webpage URLs.
URL> https://example.com/page-one
URL> https://example.com/page-two
URL

无效文本会被忽略,重复网址只处理一次。全部完成后,文件在 downloaded_images 目录里。

源文件模式:适合固定清单反复跑

把网址写进 do.py 顶部的 RAW_TEXT,然后运行:

python do.py

两种入口共用同一套提取、选图、询问改参和下载逻辑,差别只在网址从哪来。

安装

需要 Python 3.13 或更高版本,以及能访问目标网页和图片服务器的网络。依赖很少:requests 负责请求,beautifulsoup4 负责解析 HTML。

python -m venv .venv
.\.venv\Scripts\Activate.ps1
python -m pip install --upgrade pip
python -m pip install -e

如果 PowerShell 禁止激活虚拟环境脚本,先在当前会话执行:

Set-ExecutionPolicy -Scope Process -ExecutionPolicy RemoteSigned
.\.venv\Scripts\Activate.ps1

可以改的配置

都在 do.py 文件顶部:

  • SAVE_DIR:本地保存目录,默认 downloaded_images。

  • HEADERS:请求头。默认带常见浏览器 User-Agent;个别站点如果校验来源,可以打开注释里的 Referer。

它不会做的事

部分网站会拦截自动化请求,或要求登录后才能看到图片。这个工具不会绕过这些限制。仅登录可见的 Pixiv 或 Patreon 内容,在页面本身无法公开访问时会失败。

它主要认页面里的 <img> 和少数站点接口,不会去解 CSS 背景图,也不会猜测需要额外登录态才能拿到的资源。

把它当成一个诚实的小助手:给你能访问的页面,它帮你把最高清的那张捞下来;遇到墙,它会告诉你失败,而不是假装成功。

适合谁用

  • 需要把参考页、作品页或图文稿里的配图批量存档的人。

  • 经常从 Pixiv、note.com 或 Patreon 公开页备份原图,又不想为一次性任务写完整爬虫的人。

  • 已经有一串乱七八糟的文本,只想从中抽出网址再下载的人。

2026年9月22日

保存网页图片这件事,听起来简单,做起来却很烦。右键一张张另存为太慢;整页截图又糊、又裁不干净;浏览器扩展则常常把缩略图、图标和真正的内容图混在一起。

Image Downloader 是一个很小的 Python 工具:打开网页,抽出图片地址,优先拿页面已经给出的最高清版本,再存到本地。它不为了“尽可能大”去伪造签名链接,也不默认改你的图片参数。

它不追求全能爬虫,也不假装能突破登录墙。如果你经常需要把某几页上的配图备份下来,它刚好够用。

项目地址→ Github

它到底做什么

给它一个或多个网页地址,它会依次完成这些步骤:

  1. 从你粘贴的文本里识别 HTTP / HTTPS 网址,自动清理末尾标点并去重。

  2. 请求页面 HTML。Pixiv 作品页会走插画接口拿全部原图;其他站点用 BeautifulSoup 找 <img>。

  3. 在普通页面上,优先使用 data-full、data-hires、srcset,或指向图片文件的父级链接;没有更好地址时才回退到 src / data-src。

  4. 跳过 data: 内嵌图。同一张图出现多种尺寸时,只保留质量最高的那一个。

  5. 默认按原始图片链接下载。只有你主动选择改参数时,才会替换或追加查询字符串。

  6. 文件保存到 downloaded_images 目录,遇到重名会自动加前缀,避免覆盖。单张失败会跳过,同一页其余图片继续下。

关键设计是:网页地址永远不会被改写;图片地址默认也不改。 下载时会带上源页面作为 Referer,这对 Pixiv 这类图床尤其重要。

针对几个站点的额外处理

Pixiv

遇到 /artworks/{id} 作品页时,工具会请求插画元数据,拼出全部 img-original 原图地址,而不是页面上的缩略图。多页作品会按页下载。

note.com

对于 assets.st-note.com/img/ 的图片,会改写成点击放大时使用的 CDN 参数:约 4000 像素、质量 90。同一资源路径只保留一个版本。

Patreon

Patreon 的媒体地址是签名过的。工具会优先使用页面真实提供的点击原图链接(来自包围图片的 <a> 或页面内嵌数据),并原样保留访问令牌。它不会伪造新的签名 URL,也不会改写 Patreon 的查询参数。只有 hash、没有过期时间的链接会被跳过。

可选:改图片链接参数

开始下载前,程序会问要不要修改图片 URL 的查询参数。直接回车或选 n,就按原始链接下载。选 y 后,可以输入一组参数,例如:

caw=1920&format=webp

已有同名参数会被替换,新参数会被追加。页面网址不会被动;已签名的 Patreon 媒体地址也不会被改。

https://example.com/a.jpg?caw=500
→ https://example.com/a.jpg?caw=1920&format=webp

两种运行方式

交互式:适合临时粘贴一批链接

启动控制台后,每行输入一个网址,也可以一次粘贴含多个网址的文本。空行确认后继续:

python run.py


Enter one or more webpage URLs.
URL> https://example.com/page-one
URL> https://example.com/page-two
URL

无效文本会被忽略,重复网址只处理一次。全部完成后,文件在 downloaded_images 目录里。

源文件模式:适合固定清单反复跑

把网址写进 do.py 顶部的 RAW_TEXT,然后运行:

python do.py

两种入口共用同一套提取、选图、询问改参和下载逻辑,差别只在网址从哪来。

安装

需要 Python 3.13 或更高版本,以及能访问目标网页和图片服务器的网络。依赖很少:requests 负责请求,beautifulsoup4 负责解析 HTML。

python -m venv .venv
.\.venv\Scripts\Activate.ps1
python -m pip install --upgrade pip
python -m pip install -e

如果 PowerShell 禁止激活虚拟环境脚本,先在当前会话执行:

Set-ExecutionPolicy -Scope Process -ExecutionPolicy RemoteSigned
.\.venv\Scripts\Activate.ps1

可以改的配置

都在 do.py 文件顶部:

  • SAVE_DIR:本地保存目录,默认 downloaded_images。

  • HEADERS:请求头。默认带常见浏览器 User-Agent;个别站点如果校验来源,可以打开注释里的 Referer。

它不会做的事

部分网站会拦截自动化请求,或要求登录后才能看到图片。这个工具不会绕过这些限制。仅登录可见的 Pixiv 或 Patreon 内容,在页面本身无法公开访问时会失败。

它主要认页面里的 <img> 和少数站点接口,不会去解 CSS 背景图,也不会猜测需要额外登录态才能拿到的资源。

把它当成一个诚实的小助手:给你能访问的页面,它帮你把最高清的那张捞下来;遇到墙,它会告诉你失败,而不是假装成功。

适合谁用

  • 需要把参考页、作品页或图文稿里的配图批量存档的人。

  • 经常从 Pixiv、note.com 或 Patreon 公开页备份原图,又不想为一次性任务写完整爬虫的人。

  • 已经有一串乱七八糟的文本,只想从中抽出网址再下载的人。